Por qué RaceFit, el selector de corredores nacido en la Universidad Ben-Gurion y el Israel-Premier Tech, no ayudaría a un director deportivo
También disponible en inglés.
Un equipo WorldTour tiene entre 26 y 30 corredores y alinea entre 6 y 8 en cada carrera. Elegirlos es trabajo del director deportivo, y esta elección puede ser mejorada por el Machine Learning. En 2024, un grupo de la Universidad Ben-Gurion del Néguev y del Israel-Premier Tech (hoy NSN Cycling Team) publicó en PLOS ONE RaceFit (Sagi et al., 2024), un sistema de aprendizaje automático que ordena a los corredores de un equipo para una carrera próxima y anuncia hasta un 80% de precisión. Sin embargo, este modelo no le ayudaría en su trabajo a ningún director.
Qué hace RaceFit
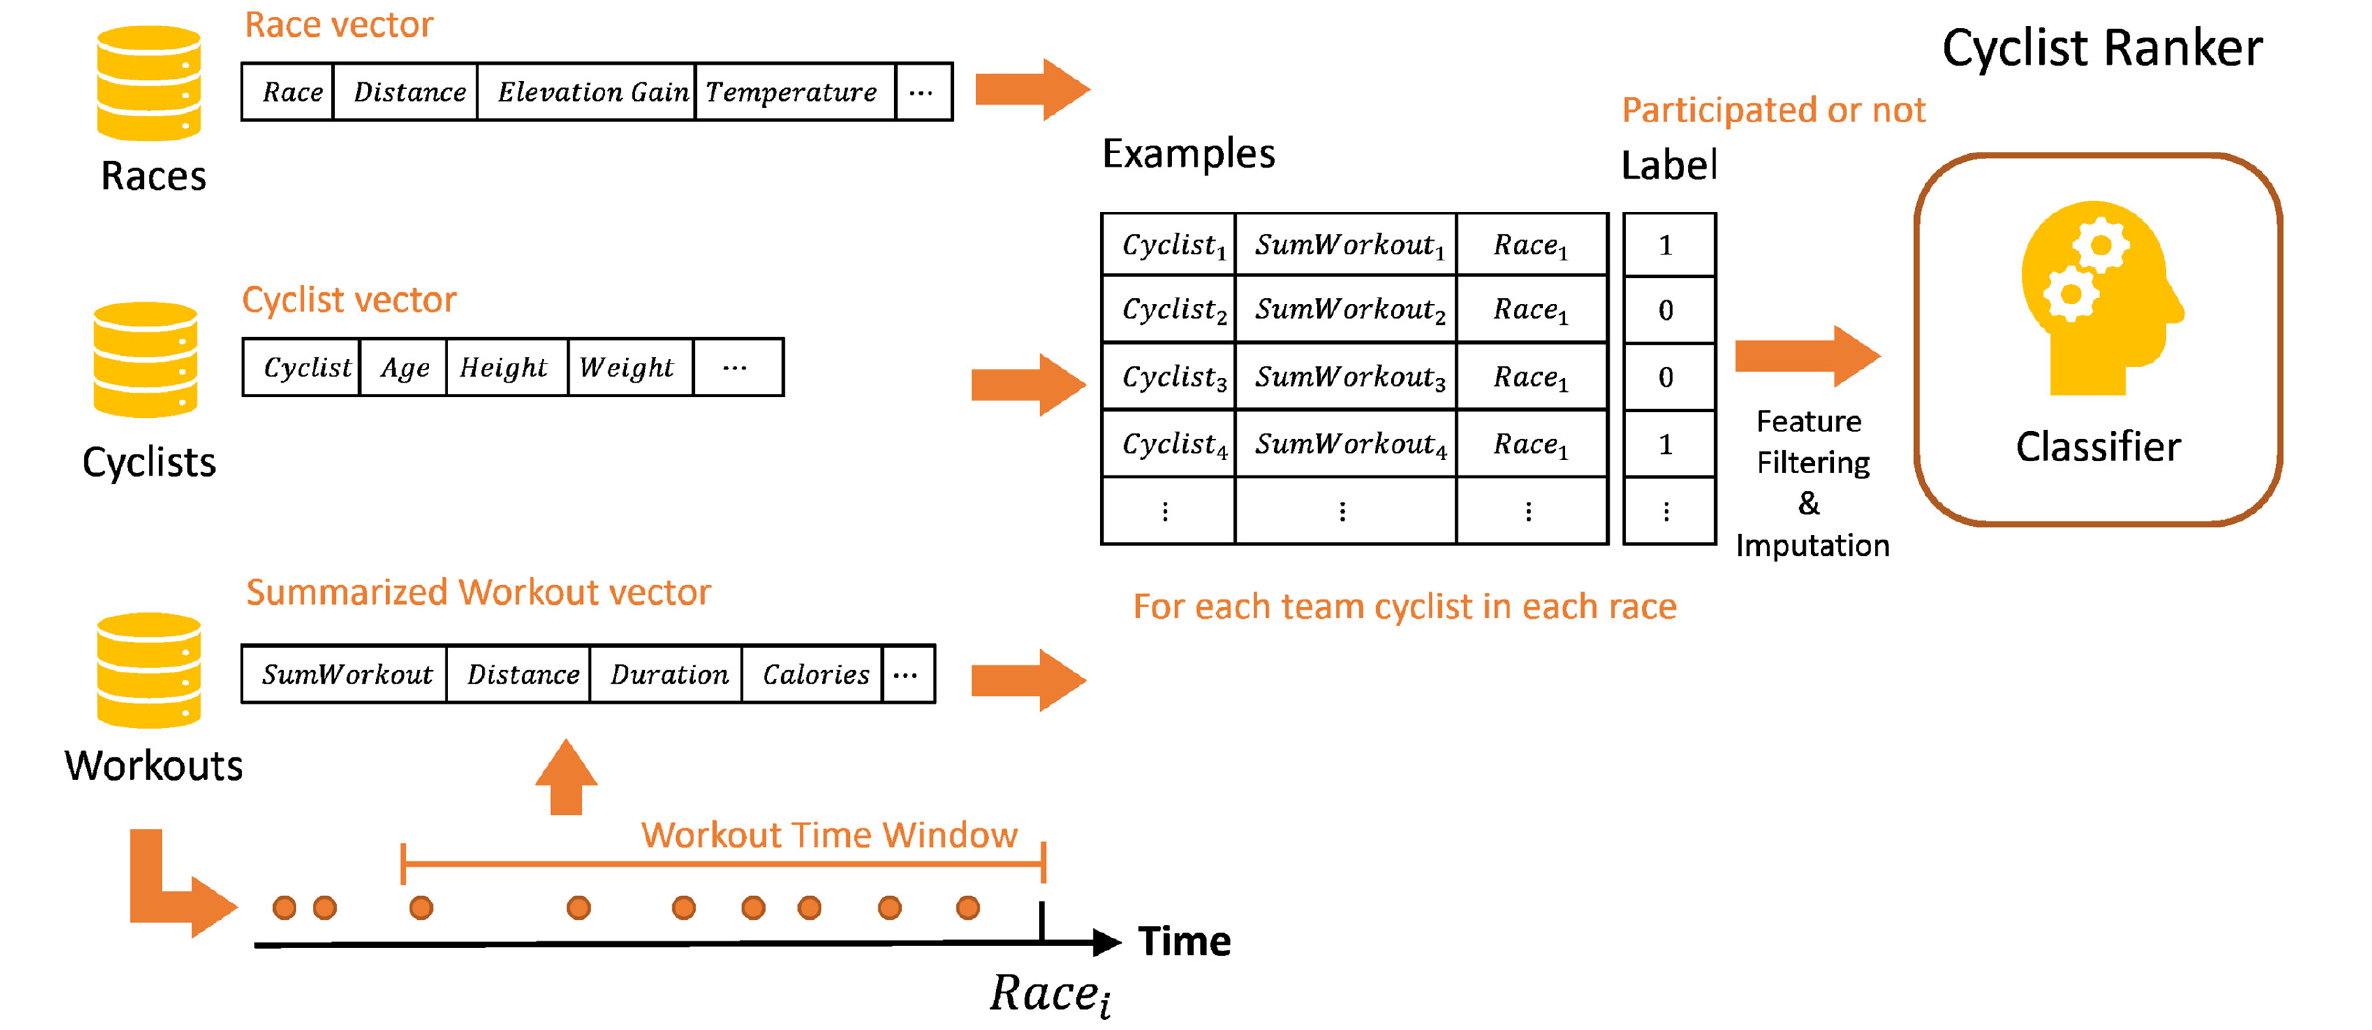
RaceFit es una herramienta de apoyo a la decisión para el director deportivo. Se le da una carrera próxima y devuelve la plantilla del equipo ordenada de más a menos recomendable para esa carrera, con una puntuación por corredor. Para construir ese orden, el sistema aprende de las alineaciones pasadas del propio equipo, junto con lo que cada corredor ha entrenado en las semanas anteriores y cómo es la carrera. Los autores lo presentan como un recomendador, como los que sugieren películas o canciones, aplicado a elegir corredores.
El paper usa datos de 583 corredores, 94.000 entrenamientos de Training Peaks y 373.000 de Strava entre finales de 2016 y 2022, y 6.000 carreras de Pro Cycling Stats entre 2010 y 2022. Se evalúan tres equipos: Israel-Premier Tech (con Training Peaks y Strava) y Jumbo-Visma y Groupama-FDJ (solo con el Strava público).
El sistema trabaja en tres pasos.
- Modelar: de los sensores a las fichas. Para cada carrera pasada del equipo y cada corredor de la plantilla se construye una ficha con tres bloques: el corredor (edad, peso, puntos, cuántas veces ha corrido con el equipo), sus entrenamientos de las cinco semanas anteriores (kilómetros, horas, desnivel, calorías) y la carrera de esa ficha (distancia, desnivel, número de etapas, categoría). A cada ficha se le asigna una respuesta: 1 si ese corredor fue alineado en dicha carrera, 0 si no.
- Entrenar: aprender de las alineaciones pasadas. Con miles de fichas y sus respuestas, un algoritmo (CatBoost, el que mejor les funcionó de los cuatro que probaron) aprende las características de las fichas que suelen llevar un 1. El orden temporal se respeta: para cada carrera se entrena un modelo solo con las carreras anteriores.
- Predecir: puntuar, ordenar, recomendar. Para una carrera nueva se rellena la ficha de cada corredor junto con la carrera futura, el algoritmo le da una puntuación entre 0 y 1, y la plantilla queda ordenada. El director pide los n que necesita más k de reserva, por ejemplo 6 + 2, y decide. Hay una segunda versión que hace lo mismo etapa por etapa y promedia las puntuaciones de las etapas en una sola por carrera.
Problema 1: aprende a imitarte
Lo primero que hay que mirar es qué intenta predecir el modelo, esto es, la variable objetivo. En aprendizaje automático esa variable se llama etiqueta y es la respuesta asociada a cada ejemplo de entrenamiento. Aquí la etiqueta es si el corredor fue alineado en esa carrera. El modelo aprende, por tanto, los patrones de selección del director deportivo, con sus hábitos, sesgos y errores incluidos. El paper presenta la salida como la probabilidad de que el corredor «encaje» en la carrera y como «las mejores posibilidades de éxito». Pero eso no es verdad: la salida del modelo es la probabilidad de que el corredor sea alineado en la carrera, que es diferente. Es decir, la salida del modelo imita la decisión del director deportivo; no hace nada por mejorarla. Los datos de entrenamiento no contienen ningún resultado de rendimiento: ni puesto, ni puntos, ni el cumplimiento de un objetivo de equipo.
El paper afirma que logran un 80% de precisión, esto quiere decir que, de los corredores que RaceFit pone en cabeza de su lista, ocho de cada diez coinciden con los que eligió el director. Una buena nota significa una buena imitación, y no dice nada de la calidad de la alineación.
Esto es como si a un ayudante nuevo le enseñas a hacer alineaciones mostrándole todas las tuyas de los últimos seis años y nada más. Aprenderá a parecerse a ti. Si tú tiendes a dejar fuera a un corredor que rinde en las clásicas con frío, él también lo dejará fuera. Sin embargo, el propósito de un modelo de recomendación debe ser mejorar la selección, hacerte ver las cosas que no ves. Un sistema que imita al seleccionador solo sirve para sustituirlo, y si el seleccionador se equivoca, el sistema se equivoca igual, sin forma de saberlo, porque nunca ha visto una buena selección marcada como buena ni una mala marcada como mala.
Problema 2: elige corredores de uno en uno
El modelo puntúa a cada corredor por separado y los siete con mejor nota van a la carrera. Una alineación es otra cosa: un sprinter necesita un tren, un líder necesita gregarios que acompañen y escaladores a su lado, una clásica pide corredores distintos de los de una gran vuelta. Puntuando de uno en uno, el modelo puede devolver siete escaladores para una carrera llana y no tiene manera de darse cuenta. Y aunque el paper menciona los métodos de otros deportes que eligen la formación en conjunto, los descarta porque «la estructura de los equipos ciclistas es parecida en todas las carreras» (página 5). Las alineaciones se construyen justo al revés: la estructura cambia con la carrera.
Problema 3: lo que de verdad ha aprendido es tu calendario
Hay una forma de preguntarle a un modelo en qué datos se fija más para decidir. Se llama importancia de variables, y el apéndice S3 del paper la enseña. Con los dos métodos más fiables (el del propio CatBoost y los valores SHAP), y en los tres equipos, dos datos dominan con mucha diferencia: a cuántos kilómetros está esta carrera del lugar de la última que corrió el corredor, y cuántas semanas hace que corrió.
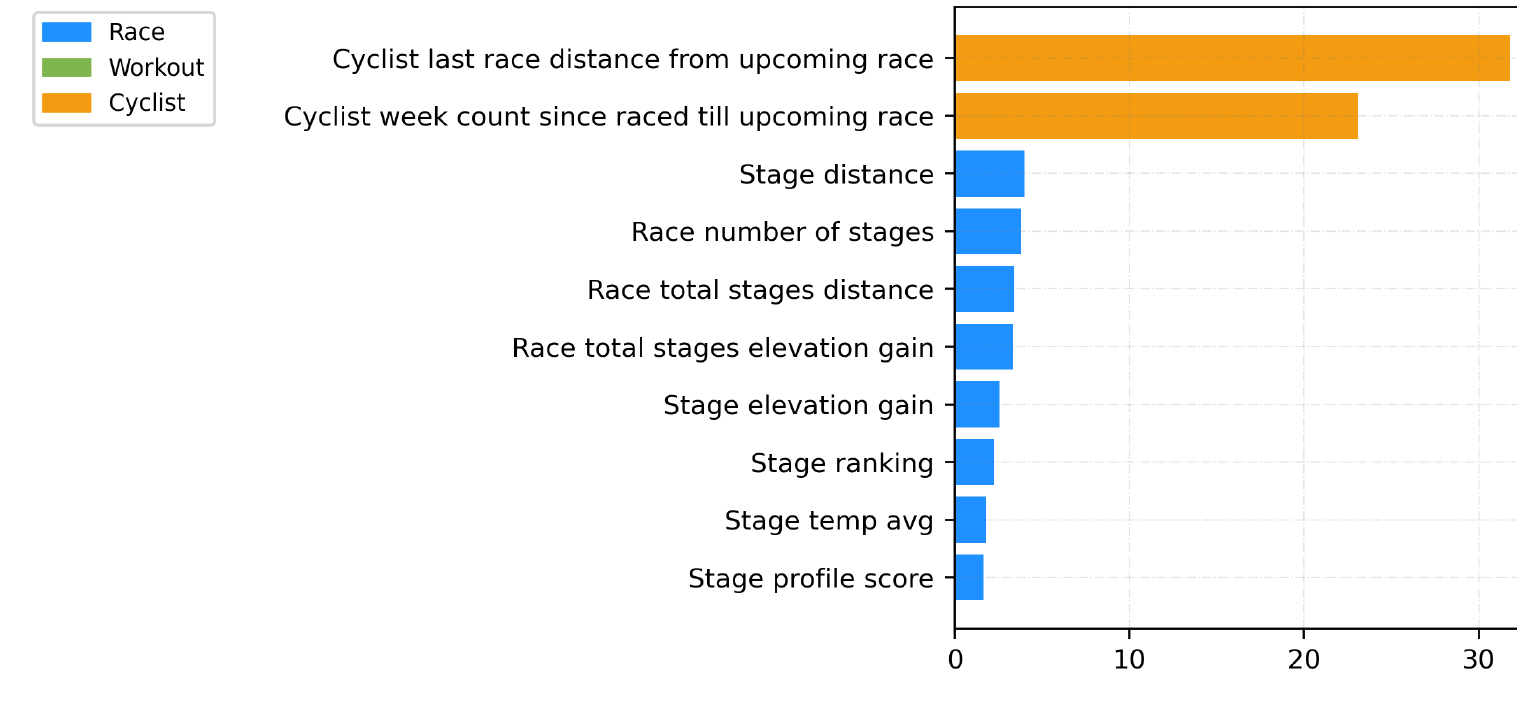
Esos dos datos son tu calendario de bloques. Un corredor que terminó en Australia esta semana no sale en Bélgica la que viene, y uno que está en mitad de un bloque sigue en el bloque. Es la parte de la decisión para la que no hace falta ningún modelo, porque ya la sabes tú. Los datos de entrenamiento, que son el argumento de venta del paper (los vatios de Training Peaks y Strava), no aparecen entre los diez primeros con ninguno de los dos métodos. Esto explica también uno de los hallazgos del paper: Training Peaks y Strava «rinden igual» porque los entrenamientos apenas mueven la lista.
Problema 4: la evaluación no se sostiene
Esta es la parte más técnica, y también la que un director puede seguir con un poco de guía.
El listón está en el suelo. Para saber si un modelo aporta algo, hay que compararlo con una regla sencilla: el baseline. El paper solo usa una, en dos variantes: alinear a los corredores que más veces han corrido («popularidad»), en general o en el continente de la carrera. Esa regla alcanza una precisión de 0,2, constante a lo largo de la curva. Elegir al azar siete corredores de una plantilla de treinta da un 23%: casi lo mismo. RaceFit supera, por tanto, un listón equivalente al azar. Faltan baselines que un director reconocería: repetir la alineación del año pasado en esa carrera, o elegir entre los corredores libres esa semana.
Ni un intervalo. Cada número del paper es una media sobre carreras. Un 0,55 de media puede ser un modelo que acierta un poco en todas o uno que acierta mucho en la mitad y nada en la otra mitad, y para un director no es lo mismo. El intervalo de confianza (entre qué valores se mueve el resultado de carrera a carrera) es lo que te dice cuánto fiarte de un número, y no aparece ninguno.
Los hiperparámetros se eligen sobre el conjunto de evaluación. El modelo tiene varios ajustes libres: cuántas semanas de entrenamiento usar, cómo imputar los datos que faltan, qué algoritmo aplicar. El paper prueba varias combinaciones, se queda con la que mejor puntúa en las mismas carreras con las que reporta el resultado, y publica esa. Eso es sobreajuste a la evaluación: la métrica deja de medir capacidad de generalizar y pasa a medir cuánto se ha adaptado el modelo a ese conjunto concreto. El procedimiento correcto es fijar los hiperparámetros en un conjunto de validación y medir el rendimiento solo después, en carreras que no hayan entrado en esa elección.
Rellenar huecos mejora demasiado. Cuando a un corredor le faltan datos, el paper los rellena con la media de todos. Solo con eso, la precisión del modelo por etapas sube de 0,35 a 0,6 (figura 7b). La media no añade información, así que ahí pasa otra cosa: lo más probable es que el hueco en sí significara algo (un corredor lesionado, uno descansando, uno con el Strava en privado) y que sin rellenar esas fichas se estuvieran tirando. El paper no lo explica.
Los mejores números vienen del modelo por etapas, y hay que comprobarlos. La versión por etapas llega a 0,77 de precisión, frente a 0,55 de la versión por carreras, y el paper lo atribuye a que tiene más ejemplos. Las etapas de una misma carrera comparten alineación, así que esos ejemplos son copias de la misma información. Y hay algo peor. Para la segunda etapa en adelante, la «última carrera» del corredor es la etapa de ayer, a cero kilómetros y cero semanas, y eso solo lo tienen los alineados. Si los dos datos que mandan en el modelo se calculan etapa a etapa, el modelo está viendo la respuesta sin querer: predice quién corre mañana mirando quién corrió hoy.
Lo que el paper hace bien
Sin embargo, no todo está mal. El problema es real y está poco estudiado, y los autores son los primeros en atacarlo con datos de un equipo. El orden temporal está bien respetado. Publicar la parte de Strava y PCS de los datos es raro en ciclismo y permite que cualquiera compruebe lo que dicen, incluido lo de arriba. CatBoost con SHAP es una buena caja de herramientas. Los fallos están en lo que se le pide al modelo que aprenda y en cómo se le examina.
Seis preguntas para quien te enseñe un modelo de selección
- ¿Cuál es la etiqueta? Si el modelo predice «a quién alineaste», aprende a reproducir tus decisiones pasadas. Pide una etiqueta ligada al rendimiento: puntos UCI, puestos, o si se cumplió el objetivo del equipo en esa carrera.
- ¿Puntúa corredores sueltos o alineaciones completas? Un sprinter sin tren, o siete escaladores en una carrera llana, pueden salir bien en un ranking individual y ser una mala alineación. La unidad de evaluación es el equipo que sale a la carretera.
- ¿Contra qué baseline se compara? Pide listones que reconozcas: la alineación del año pasado en esa carrera, los corredores libres esa semana, o tus propias elecciones. Si el único listón es «popularidad» o el azar, la victoria es fácil de conseguir.
- ¿Cuál es el intervalo de carrera a carrera? Una media de 0,55 puede ser un modelo estable o uno que acierta mucho en unas carreras y nada en otras. Sin intervalo de confianza o dispersión, no hay forma de saber cuánto fiarse del número.
- ¿En qué variables se apoya la decisión? Pide una importancia de variables (SHAP o la del propio algoritmo). Si mandan el calendario y el descanso, el sistema está reproduciendo tu agenda; si mandan carga, perfil de carrera o historial de rendimiento, hay algo que mirar.
- ¿Se ha evaluado hacia delante, en tiempo real? La prueba seria es una temporada en la que la recomendación se guarda antes de cada carrera y solo después se compara con la alineación real y con el resultado. Evaluar sobre el pasado, con los hiperparámetros ya ajustados a esas mismas carreras, no basta.
Si diriges un equipo y alguien te presenta un modelo de selección, estas son las preguntas que deberías hacerle. Ayudar a los equipos a hacerlas es parte de lo que hago.
Referencia
Sagi, M., Saldanha, P., Shani, G., & Moskovitch, R. (2024). Pro-cycling team cyclist assignment for an upcoming race. PLOS ONE, 19(3), e0297270. doi:10.1371/journal.pone.0297270. Figuras reproducidas bajo licencia CC BY 4.0.
¿Sin cuenta de GitHub? Escríbeme a .